
Questo blog, in questo momento, usa tre API di intelligenza artificiale di tre provider diversi. Il widget “Chiedi al blog” risponde con GPT-6 Luna di OpenAI, la versione audio della Rassegna AI la legge una voce di Gemini di Google, e al lavoro il chatbot interno che ho costruito per l’azienda con cui collaboro gira su Claude Haiku di Anthropic. Nessuno di questi passa da ChatGPT o da un abbonamento: sono tutte chiamate API, pagate a consumo, un token alla volta.
Se finora hai usato ChatGPT, Gemini o Claude dal browser, le API sono un altro mondo: niente interfaccia, niente canone fisso e un listino che a prima vista sembra scritto apposta per confondere. In questa guida ti spiego come funzionano, come si leggono i prezzi, cosa guardare oltre al costo e come fare la prima chiamata senza trovarti sorprese sulla carta di credito.
È il primo articolo di una serie: qui trovi il quadro generale, poi ogni sezione avrà il suo approfondimento. I numeri che cambiano ogni settimana, cioè prezzi e modelli nuovi, li tengo aggiornati nel tracker dei modelli IA, così questa guida resta valida anche tra sei mesi.
Cosa sono le API di intelligenza artificiale (e perché non sono ChatGPT)
Un’API è una porta d’ingresso pensata per i programmi, non per le persone. Il tuo codice manda una richiesta HTTP con del testo dentro, il server del provider la passa al modello e ti restituisce la risposta. ChatGPT, Gemini e l’app di Claude sono prodotti costruiti sopra questi modelli; l’API è il modello “nudo”, senza tutto quello che ci mettono intorno. Se ti incuriosisce come ci siamo arrivati, ho raccontato la storia dei chatbot da ELIZA a GPT-6.
Le differenze pratiche sono quattro:
- Paghi quello che usi. Niente abbonamento mensile: paghi in base a quanto testo mandi e ricevi. E attenzione, l’abbonamento a ChatGPT Plus o a Claude Pro non include le API: sono conti separati, con fatturazione separata.
- Non c’è un’interfaccia. Quella la costruisci tu: un chatbot sul sito, uno script che riassume le mail, un’automazione che classifica i ticket.
- Non c’è memoria. Il modello non si ricorda niente tra una chiamata e l’altra. Ci torno tra poco perché è importante.
- Hai il controllo di tutto. Scegli il modello, scrivi le istruzioni di sistema, decidi quanto può essere lunga la risposta e in che formato deve arrivare.
Com’è fatta una chiamata
Per capire di cosa parliamo, ecco una chiamata vera all’API di Anthropic fatta da terminale con curl:
curl https://api.anthropic.com/v1/messages \
  -H "x-api-key: $ANTHROPIC_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-haiku-4-5",
    "max_tokens": 300,
    "system": "Rispondi in italiano, in modo breve.",
    "messages": [
      {"role": "user", "content": "Spiegami cosa sono i token in due righe."}
    ]
  }'
Dentro ci sono i pezzi che trovi in qualsiasi API di questo tipo: il modello da usare, il limite massimo di lunghezza della risposta, le istruzioni di sistema (il “carattere” che vuoi dare al modello) e i messaggi della conversazione. Nella risposta, oltre al testo, arriva un blocco usage con il numero di token letti e scritti. Quel blocco è la tua bolletta: conviene salvarlo da subito.
Con OpenAI, Google e gli altri i nomi dei campi cambiano un po’, ma il concetto è identico. Molti provider, tra cui DeepSeek e OpenRouter, offrono anche un endpoint compatibile con il formato di OpenAI, così cambiare modello diventa questione di cambiare un indirizzo e una chiave.
Il modello non si ricorda niente
Ogni chiamata parte da zero. Quando in ChatGPT fai una domanda di seguito all’altra, dietro le quinte l’app rimanda al modello tutta la conversazione a ogni turno. Con le API quel lavoro tocca a te: se vuoi una chat, a ogni messaggio devi rimandare anche tutti quelli precedenti.
La conseguenza è semplice e spesso sottovalutata: una conversazione di venti turni, all’ultimo turno, ti fa pagare la lettura di tutti e venti. Alcune API offrono di tenere la conversazione lato server, ma in genere quei token li paghi lo stesso. È la prima cosa da capire, perché spiega metà dei conti inaspettati.
I token: l’unità di misura delle API IA
I modelli non leggono parole ma token, pezzi di testo che possono essere una parola intera, una sillaba o un segno di punteggiatura. Tutto si misura in token: quanto testo il modello può leggere, quanto ne può scrivere e quanto paghi.
Come stima a occhio, in inglese un token vale circa tre quarti di parola. In italiano di solito servono un po’ più token per dire la stessa cosa, perché i tokenizer sono addestrati soprattutto su testi inglesi e spezzano di più le nostre parole. In più ogni provider ha il suo tokenizer, quindi lo stesso testo può “pesare” in modo diverso su due modelli diversi.
I token si dividono in due famiglie, e si pagano in modo diverso:
- Input: tutto quello che mandi. Istruzioni di sistema, cronologia della chat, documenti allegati, immagini, la domanda vera e propria.
- Output: tutto quello che il modello scrive. Compresi i token di “ragionamento” dei modelli che pensano prima di rispondere: non sempre li vedi, ma li paghi come output.
Quanto costano le API di intelligenza artificiale: come leggere un listino
I prezzi si esprimono quasi sempre in dollari per milione di token, con due numeri separati: uno per l’input e uno per l’output. L’output costa sempre di più, di solito da 3 a 8 volte l’input, molto spesso 5. Ecco qualche esempio preso dai listini ufficiali a fine settembre 2026:
| Modello | Fascia | Input | Output |
|---|---|---|---|
| GPT-6 Luna | Economica | $0,10 | $0,50 |
| DeepSeek V4.1 Flash | Economica | $0,15 | $0,60 |
| Claude Haiku 4.5 | Intermedia | $1 | $5 |
| Claude Sonnet 5 | Intermedia | $2 | $10 |
| GPT-6 Sol | Intermedia | $2 | $10 |
| Claude Opus 5.5 | Alta | $4 | $20 |
| Claude Fable 5.1 | Alta | $10 | $50 |
| GPT-6 Astra | Alta | $10 | $50 |
Tra il modello più economico e quello più caro della tabella c’è un fattore 100. Per questo scegliere il modello è la decisione che pesa di più sul costo, molto più di qualsiasi ottimizzazione successiva. I listini completi li trovi sulle pagine ufficiali di Anthropic, OpenAI e Google.
Le voci che non vedi subito
Il prezzo in prima riga è solo l’inizio. Nei listini ci sono quasi sempre altre voci, alcune a tuo favore e altre no:
- Cache. Se mandi spesso lo stesso inizio (istruzioni lunghe, lo stesso documento di riferimento), la parte ripetuta può essere letta dalla cache a una frazione del prezzo. Su Claude Fable 5.1, per dire, la lettura dalla cache costa il 2,5% del prezzo di input.
- Batch. Se la risposta non ti serve subito, puoi mandare le richieste in blocco e riceverle entro qualche ora. Anthropic e OpenAI lo fanno a metà prezzo.
- Contesto lungo. Oltre una certa soglia di input alcuni modelli costano di più. GPT-6 Astra passa da $10 / $50 a $20 / $75, Gemini 3.1 Pro oltre i 200.000 token da $2 / $12 a $4 / $18.
- Fasce orarie. DeepSeek ha prezzi diversi tra ore di punta e fuori picco: nelle ore di punta costa il doppio.
- Prezzi di lancio. Gemini 3.8 Flash costa $0,75 / $3,75 fino al 31 dicembre 2026, poi il prezzo raddoppia. Se ci costruisci sopra un progetto, fai i conti con il prezzo pieno.
Un esempio concreto: quanto costa un chatbot aziendale
Prendiamo un caso che conosco bene: un chatbot che risponde alle domande dei colleghi pescando dalla documentazione interna. A ogni domanda il modello riceve circa 3.000 token di input (istruzioni, i pezzi di documento pertinenti, la domanda) e scrive circa 400 token di output. Mettiamo 10.000 risposte al mese, cioè una squadra di qualche decina di persone che lo usa ogni giorno.
Con Claude Haiku 4.5 una risposta costa 3.000 × $1 / 1.000.000 = $0,003 di input più 400 × $5 / 1.000.000 = $0,002 di output. Mezzo centesimo. Moltiplicato per 10.000 risposte:
- GPT-6 Luna: circa $5 al mese
- Claude Haiku 4.5: circa $50 al mese
- Claude Fable 5.1: circa $500 al mese
Stesso lavoro, cento volte di differenza. E per un chatbot che deve ritrovare informazioni in una documentazione e riassumerle bene, un modello di punta è quasi sempre sprecato: la qualità della risposta dipende molto di più da quali pezzi di documento gli passi che dalla potenza del modello. Aggiungendo la cache sulle istruzioni ripetute, poi, il conto scende ancora.
Context window e output massimo
La context window è la quantità massima di token che il modello può gestire in una singola richiesta, tra quello che legge e quello che scrive. Oggi quasi tutti i modelli principali arrivano a un milione di token, cioè più di mille pagine di testo; alcuni, come Claude Haiku 4.5, si fermano a 200.000, che restano comunque qualche centinaio di pagine.
Poi c’è un limite separato sull’output massimo, cioè quanto può essere lunga la risposta: 128.000 token per Claude Opus 5.5 e GPT-6 Sol, 64.000 per Haiku 4.5. Conta quando devi generare documenti lunghi o molto codice in una volta sola.
Due avvertenze. La prima: tutto quello che metti nel contesto lo paghi, a ogni chiamata. Riempire un milione di token con Claude Opus 5.5 costa $4 solo di input, e se lo fai a ogni domanda il conto vola. La seconda: che un documento “ci stia” non vuol dire che il modello lo usi bene tutto. Con input molto lunghi i dettagli si perdono più facilmente, ed è per questo che nei chatbot aziendali si recuperano solo i pezzi pertinenti invece di passare l’intera documentazione.
Cosa guardare oltre al prezzo quando scegli un’API di intelligenza artificiale
Il prezzo è il primo filtro, non l’unico. Quando scelgo un modello per un progetto guardo anche queste cose.
La qualità sul tuo caso d’uso
I benchmark dicono quanto un modello è bravo su test standard, non sul tuo lavoro. Il metodo che funziona è banale: prepari venti o trenta domande vere del tuo caso d’uso, le fai a due o tre modelli candidati e confronti qualità e costo per risposta. Mezza giornata di lavoro che ti evita mesi di bollette sbagliate.
La velocità
Conta quanto ci mette ad arrivare la prima parola e quanti token al secondo genera. In un chatbot la differenza tra un secondo e cinque si sente tutta; in un processo notturno che riassume documenti non interessa a nessuno.
I rate limit
Ogni account ha un tetto di richieste e di token al minuto. Sugli account nuovi i limiti sono bassi e crescono man mano che spendi, a livelli chiamati tier. Se prevedi picchi di traffico, controlla i limiti prima del lancio, non il giorno dopo.
Le funzioni disponibili
Non tutti i modelli fanno tutto. Le funzioni da verificare sono l’uso di strumenti (il modello che chiama funzioni del tuo codice), l’output strutturato in JSON affidabile, la lettura di immagini e PDF, la voce. Se il tuo progetto ne richiede una, è un criterio che viene prima del prezzo.
Dove finiscono i dati
Per quanto tempo il provider conserva le richieste, se le usa per addestrare i modelli, in quale regione stanno i server. Se mandi dati di clienti o colleghi è una domanda che devi farti prima di scrivere la prima riga di codice, anche per gli obblighi del GDPR e dell’AI Act. Su quest’ultimo ho scritto cosa deve fare davvero una PMI nell’articolo sull’AI Act dopo il 2 agosto 2026.
Pesi aperti o modello chiuso
Modelli come DeepSeek, Kimi, GLM e Mistral hanno i pesi aperti: oltre a usarli via API puoi scaricarli e farli girare su server tuoi, se hai l’hardware. Anche se non lo farai mai, sapere che l’alternativa esiste riduce il rischio di restare legato a un solo fornitore.
Come iniziare con le API IA: la checklist
Questa è la sequenza che seguo ogni volta che apro un account su un provider nuovo:
- Crea l’account sulla console del provider e genera una chiave API. Una chiave per progetto, così se devi revocarne una non fermi tutto il resto.
- Imposta subito un limite di spesa e un avviso via mail. Prima di qualsiasi altra cosa: un ciclo infinito nel codice alle tre di notte è un’esperienza che non auguro a nessuno.
- Metti la chiave in una variabile d’ambiente, mai scritta nel codice e mai committata su Git.
- Fai le prime prove nel playground della console: provi istruzioni e modelli senza scrivere codice.
- Passa al codice con l’SDK ufficiale del provider o con una semplice richiesta HTTP come quella sopra.
- Registra l’
usagedi ogni chiamata dal primo giorno: modello, token di input e di output, costo stimato. Quando arriva la prima fattura saprai esattamente da dove viene.
Se vuoi provare tanti modelli senza aprire dieci account, c’è anche OpenRouter: una sola chiave e un solo credito per centinaia di modelli di provider diversi. Comodo per sperimentare, poi in produzione si valuta se restare o passare al provider diretto.
Gli errori da evitare
- La chiave API nel frontend. Se la chiamata parte dal JavaScript del browser, la chiave è visibile a chiunque apra gli strumenti per sviluppatori. Le chiamate vanno sempre fatte dal server.
- Nessun tetto di spesa. Vedi punto 2 della checklist. Non è paranoia, è igiene.
- Il modello top per tutto. Classificare un ticket o estrarre una data da una mail non richiede il modello più potente sul mercato. Parti dal più economico che fa bene il lavoro e sali solo se serve.
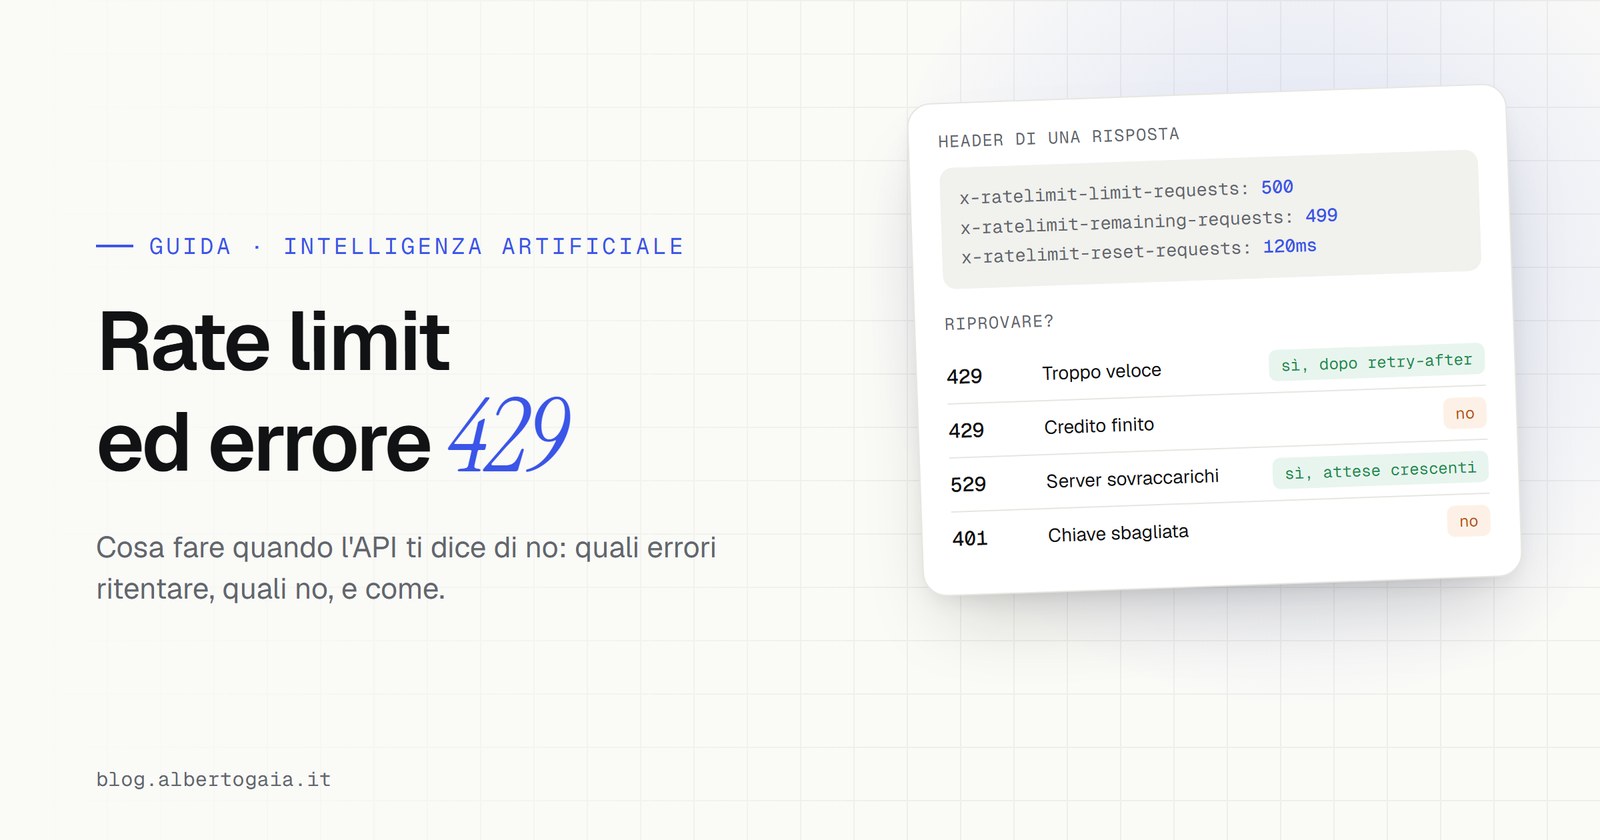
- Nessuna gestione degli errori. Il 429 (troppe richieste) e i 5xx, come il 529 di Anthropic quando i server sono sovraccarichi, prima o poi arrivano. Serve un retry con attesa crescente, altrimenti l’utente vede solo un errore.
- La cronologia che cresce all’infinito. Visto che a ogni turno rimandi tutta la conversazione, dopo un po’ conviene tagliare i messaggi più vecchi o riassumerli.
Domande frequenti sulle API di intelligenza artificiale
Le API costano come ChatGPT Plus?
No, funzionano in modo diverso. L’abbonamento è un canone fisso per usare l’app; le API si pagano a consumo. Per un uso leggero bastano pochi dollari al mese, per un prodotto con migliaia di utenti si sale parecchio. E l’abbonamento non include le API: sono due conti separati.
Serve saper programmare?
Per fare le prime prove no: il playground della console ti fa provare modelli e istruzioni da browser. Per integrarle in un sito o in un’applicazione servono le basi, oppure uno strumento di automazione come n8n o Make, che ha già i connettori pronti.
I provider usano i miei dati per addestrare i modelli?
Per le API a pagamento, OpenAI, Anthropic e Google dichiarano di non usare i dati per l’addestramento, salvo che tu scelga esplicitamente di condividerli. Le cose cambiano con i piani gratuiti: su quello dell’API Gemini Google usa richieste e risposte per migliorare i suoi prodotti. Occhio anche al fatto che “non addestrare” non vuol dire “non conservare”: OpenAI, per esempio, tiene i log fino a 30 giorni per i controlli anti abuso.
Qual è l’API di intelligenza artificiale più economica?
Dipende da cosa ti serve, ma a fine settembre 2026 tra i più economici ci sono GPT-6 Luna, DeepSeek V4.1 Flash e Qwen3.8-Omni-Flash, tutti a 15 centesimi o meno per milione di token di input. Nel tracker dei modelli IA puoi ordinare la tabella per prezzo e vedere la classifica aggiornata.
Si possono usare le API gratis?
In parte sì. Google ha un piano gratuito per l’API Gemini con limiti bassi, e alcuni provider danno crediti iniziali ai nuovi account. Per imparare e fare prove bastano; per un progetto vero conviene passare al piano a pagamento, anche per le condizioni sui dati viste sopra.
Cosa trovi nei prossimi articoli
Questa guida è il punto di partenza di una serie sulle API dei modelli IA. Nelle prossime settimane escono gli approfondimenti, e li collego qui man mano che vengono pubblicati:
- Token spiegati bene: come contarli e perché l’italiano costa di più
- Come leggere un listino prezzi delle API IA senza sorprese
- Context window: cosa vuol dire un milione di token nella pratica
- Prompt caching e Batch API: come tagliare i costi
- Rate limit ed errori 429: cosa fare quando il provider ti dice di no
- Output strutturato e tool use: far lavorare il modello con il tuo codice
- Come scegliere il modello giusto per un progetto reale
Nel frattempo, i prezzi aggiornati sono nel tracker dei modelli IA, e se vuoi sapere quando esce un modello nuovo (o un nuovo articolo della serie) la Rassegna AI arriva ogni mattina via newsletter, sul canale Telegram e sul canale WhatsApp.

Lascia un commento